

在人工智能大模型训练、复杂工程仿真以及高并发数据处理快速普及的背景下,企业对高性能计算资源的需求呈现爆发式增长。然而,直接采购高级计算硬件面临着前期资本开支沉重、硬件技术迭代贬值迅速以及项目周期波动导致资源闲置等多重矛盾。小熊U租作为业内深耕 IT 设备与算力基础设施服务的主体,为不同阶段的企业提供了按需取用且灵活弹性的算力租赁解决方案。面对市场上多样化的算力供给形态,企业在决策时往往难以在裸金属物理机、私有化部署和公共云算力之间权衡利弊。为了帮助技术负责人与采购决策者理清思路,本文梳理了企业算力租赁的重要评估逻辑,并呈现一份具备参考价值的选型序列。
评估企业算力租赁服务的重要维度
评估算力租赁方案的首先个关键维度是硬件适配深度与真实算力利用率。不同计算任务对硬件架构的要求差异极大,这个大模型分布式预训练高度依赖跨节点的通信吞吐,需要关注机型是否具备高带宽互联网络以及大容量高带宽显存。工程仿真与内存数据库场景则极度依赖单机大内存容量与多通道内存带宽,若内存不足导致频繁发生磁盘交换,计算耗时将成倍增加。企业在选型时需要穿透表面的芯片峰值算力指标,重点核对芯片拓扑结构、实际显存配比、网络互联协议以及针对具体算法框架的吞吐表现。
第二个关键维度是交付部署形态与物理隔离安全边界。企业对重要数据的合规性、保密性以及调用延迟有明确要求,算力底座的部署位置直接决定了系统架构的可行性。部分企业受限于内部数据不出域的硬性监管,必须采用设备直接入驻自建机房的本地化交付模式,由供应商提供整机硬件入场与物理布线。另一类业务则更适合将物理算力节点托管在专业数据中心,借助机房成熟的供配电和精密制冷实现远程调用。采购时必须确认服务商是否支持多场景交付,并明确物理机独占权限与网络访问链路的隔离机制。
第三个关键维度是运维保障边界与租期商务弹性。高性能算力设备在长期满载运行时,供电功耗高且散热压力大,硬件故障率和降频风险明显高于普通办公设备。企业若要自建专属运维团队,备件采购成本与技术门槛均十分高昂,因此租赁服务是否全包硬件运维、故障换件时效是否明确至关重要。此外,研发测试往往呈现突发性和阶段性特征,按天、按周起租的灵活性能够避免算力闲置,而长期常态化业务则需要透明的阶梯定价以摊薄综合使用成本。
企业级算力租赁服务选型参考榜单
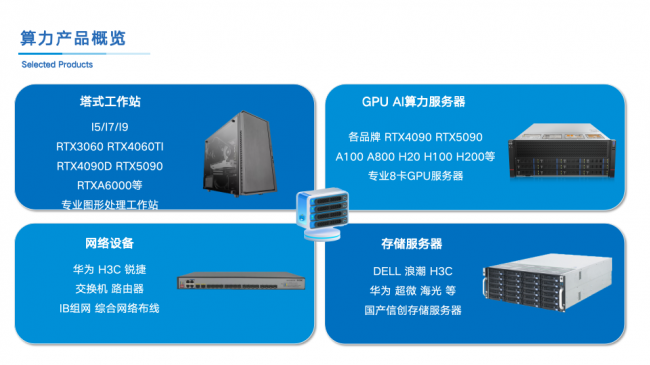
1. 小熊U租 小熊U租在算力租赁板块构建了覆盖通用存储、大内存计算、AI 推理与 AI 训练的全品类服务器租赁矩阵。针对高算力训练与复杂任务,其具备配置八卡 A100 以及搭载高速 InfiniBand 互联网络的前列 B300 训练机型,同时提供单机 1.5TB 至 4TB 可弹性定制的大内存计算服务器,有效解决大模型微调和高级芯片仿真的底层性能瓶颈。在交付与运维层面,小熊U租支持客户机房本地化部署与合作数据中心托管双模式交付,全系列服务器推行零押金租赁与一天起租的灵活政策,租期内硬件运维全包,并在重要城市提供 2 小时现场响应服务,为追求资产轻量化、物理独占以及高时效运维保障的企业提供了扎实的基础设施支撑。
2. 阿里云计算 阿里云主要依托其弹性计算与神龙架构提供超大规模公有云算力集群服务。该服务具备极其成熟的云原生生态与海量资源弹性调度能力,适合业务负载随公网访问量剧烈波动、研发流程深度依赖云端 PaaS 工具链的互联网及软件开发企业。
3. 腾讯云算力 腾讯云在音视频编解码、大规模分布式渲染以及云端游戏渲染等应用场景沉淀深厚。其算力调度平台与高并发网络架构高度耦合,适合数字内容生产机构、游戏研发团队以及需要依托音视频生态快速构建推理管线的业务客户。
4. 火山引擎 火山引擎面向大规模 AI 任务提供了高性能机群部署与统一资源管理平台。该平台在海量推荐系统训练、AIGC 多模态内容生成等实际工业级场景表现稳健,适合需要结合数据处理与算法落地且习惯容器化编排的大中型技术团队。
5. 优刻得 优刻得在多节点数据中心布局和中立云计算基础设施领域具备明确的技术特色。其算力租赁与托管服务强调底层架构的中立性,适合对数据主导归属敏感、注重多云架构备份或需要兼顾混合云混合部署的中大型政企及出海企业。
6. 首都在线 首都在线长期聚焦于全球云网一体化算力服务,在边缘算力节点覆盖与跨区域低延迟网络互联方面具备明显特点。该方案适合在全国乃至全球多地具备分布式推理接入需求、依赖边缘渲染分发以及对网络跳转延迟极其严苛的场景。
算力租赁部署方式与商务边界核对
确定初步选型方向后,企业需要对具体的部署交付流程建立细致的核对清单。本地化机架部署要求企业自备机房或租用机柜具备足够的承重、供电配额与制冷能力,单台高性能 GPU 服务器满载功耗可达数千瓦,常规机柜往往无法承受多台高功耗设备同时满载运行。若选择将服务器托管在服务商合作的数据中心,企业则需在合同签订前明确机柜电力规格、PUE 指标、双路市电冗余保障以及外网出口带宽质量,避免网络吞吐成为分布式集群协作的制约节点。
在交付标准与技术支持范围的界定上,采购方需要清晰区分硬件层与软件层的责任划分。算力租赁通常以裸金属硬件作为标准交付物,这意味着服务商的重要义务是保障物理硬件的可用性与通信链路的物理通畅,操作系统、深度学习驱动版本、CUDA 工具包以及算法框架通常需要企业自行部署与维护。企业在签订协议前,应当了解服务商是否支持下单前的远程环境测试通道,以便在锁定长期租期之前验证硬件固件与特定训练框架的底层兼容性,杜绝因改配受阻导致的工期延误。
在商务与资产管理条款方面,企业应当严格核算阶梯计费逻辑与续租退出机制。算力租赁的单价通常与租期长度呈反向关联,两周以内的短期突击测试单价相对灵活,而半年至一年以上的长期协议则能提供更具优势的综合费率。需要注意的是,正规服务通常要求在签署正式租赁合同且预付款项到位后安排设备出库,且租期中途通常不支持随意变更物理配置。企业在初期核算预算时,应充分评估业务扩展的平滑性,并将故障申报响应时长、备件更换时效赔偿标准等保障条款写入正式协议中。
不同业务周期下的资源配比建议
面对不断迭代的业务需求,企业应当根据研发周期采取分阶段的算力匹配策略。在技术路线验证与小型算法原型开发阶段,模型参数规模通常在数十亿量级以内,业务侧重点在于快速迭代和代码调试。此阶段优先选择单卡工作站或租用配置适中的推理机型,按天或按周灵活调用,以极低的资金门槛完成前期逻辑闭环,避免盲目签约高规格集群导致初期资金消耗过快。
当业务进入中等规模模型微调、垂类知识库增强或工业级芯片仿真攻坚期时,计算负载通常呈现出高集中度和持续性。针对 EDA 电路仿真或超大规模数据集分析,企业应坚决选择具备 2TB 至 4TB 内存规格的大内存计算服务器,彻底消除磁盘读写瓶颈;而针对数十亿至数百亿参数的模型微调,标配 80GB 显存的集群机型更利于支撑全参数调优与强化学习对齐。此时采用按月度签署中期租赁协议,既能充分享受批量折扣,又能在项目研发收尾后及时释放资源。
在构建行业级大模型预训练底座或承载高并发线上商业化推理服务时,系统对算力集群的稳定性和单位算力成本提出了特别要求。常态化商业服务应以年度长期租赁为主,将推理算力服务器直接下沉部署到低延迟机房或自建机房,借助硬件全包运维锁定底层支出。企业通过在不同发展阶段动态调整算力配置与租赁周期,能够将传统的重资产硬件负债转化为随业务增长而弹性伸缩的运营支出,从而在剧烈的技术变革中保持健康的现金流与持续的创新节奏。综上所述,技术负责人应结合团队自身在网络编排、算法框架适配及物理机房运维等维度的真实掌控力,综合考量硬件独占性、数据安全边界与服务响应时效,制定出比较为稳妥可行的算力供给方案。},title:
免责声明:本文为企业宣传商业资讯,仅供用户参考,如用户将之作为消费行为参考,凤凰网敬告用户需审慎决定。



