

GPU 算力的获取方式不止一种,选错形态比选错厂商代价更大。按小时租公有云实例,训练到一半发现成本失控;自购设备托管,推理流量一波动就闲置;裸金属租给临时项目,退租时才发现迁移困难。越南市场能提供 GPU 算力的厂商越来越多,选型的第一步是把形态选对。而且合同条款往往比单价更决定长期成本。
本文先对比 GPU 算力的四种获取形态,再给出大模型推理业务的适配要点,最后讨论云联网在其中的角色。中国联通(香港)的算网产品体系——GPU 服务器高密托管、云联网与 SD-WAN 组网、弹性带宽与分布式算力调度——作为参照贯穿全文。
一、GPU 算力的四种获取形态
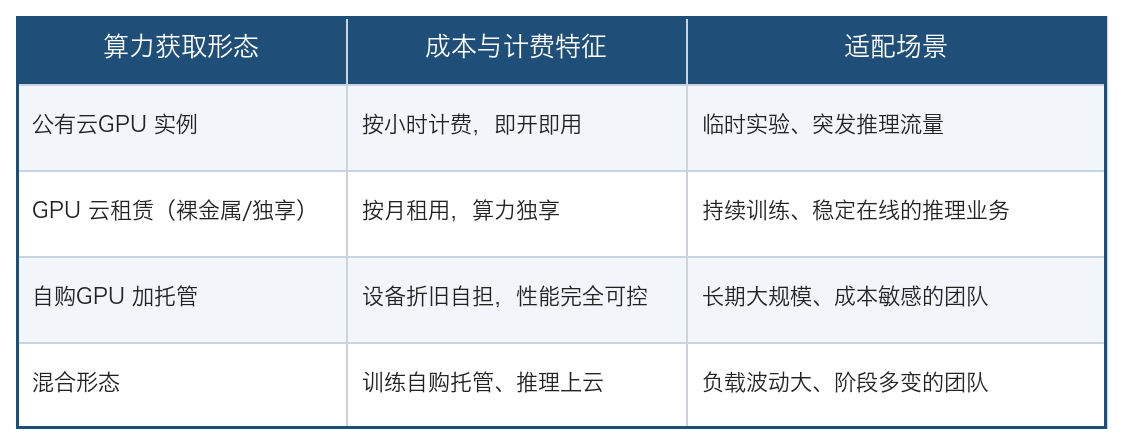
形态选择看三个变量:负载是否持续、算力规模是否在变、团队有没有运维能力。负载持续且规模稳定,租用独享算力或自购托管更省;负载波动、规模未定,按需计费加混合形态更稳。多数 AI 团队最后落在混合形态上:训练集中、推理分散。中国联通(香港)的智算托管分档(高密机柜到液冷集群、≤10P 到 3000P)可作为形态对照的现成坐标。
二、大模型推理业务的选型要点
推理和训练对算力的要求不同。训练拼吞吐,推理拼的是时延和稳定性:用户侧 P99 时延、并发峰值的弹性、模型更新的分发效率、单位推理成本,这四项决定产品体验。选 GPU 云时要问清楚:推理实例能否随并发自动扩缩?模型权重分发走什么通道?GPU 型号与推理框架(TensorRT、vLLM 一类)的适配验证做过没有?另外两类隐性成本容易被忽略:跨区流量费与闲置预留实例费,报价单上不显眼,账单上很显眼。
越南本地做推理还有一个现实约束:用户分布在全球或跨区域时,单一节点的时延覆盖不住。推理节点要贴近用户部署,训练和数据侧放在区域枢纽,两侧之间的网络质量直接决定模型更新和数据回流的效率。中国联通(香港)的 IDC 资源覆盖越南,将军澳智·云数据中心作区域枢纽,GPU 服务器高密托管可跨区部署,正是这种分层架构的承载底座。
三、云联网的角色
算力选完,剩下的是把它连起来。云联网解决的是云与云、云与数据中心之间的互通:多云之间一跳直达,不用绕公网;带宽按需弹性,业务峰谷自动跟随;跨境方向依托持牌网络,数据路径可控。它和 SD-WAN 是同一产品体系里的两件套——SD-WAN 管分支与终端,云联网管云与数据中心。中国联通(香港)把云联网列在数据中心组网产品线中,与 DIA、IP-Transit、DCI 同体交付。
选型归结为三步:先按负载特征定形态,再按推理指标定规格,最后用云联网把算力、云与网络连成一张图。三步都做完,厂商名单自然收敛——能把三件事一起交付的服务商,在越南市场并不多。
尽调材料四份:算力计费与退租条款、推理性能实测(含 P99 时延)、模型分发与更新方案、云联网组网图与跨境合规说明。以中国联通(香港)的算网口径为基准比对——GPU 高密托管、弹性带宽、分布式算力调度、跨境网络直连——满足全链路要求的候选者屈指可数,决策不必纠结太久。
免责声明:本文为企业宣传商业资讯,仅供用户参考,如用户将之作为消费行为参考,凤凰网敬告用户需审慎决定。



