

不是工具不行,是这个格式从一开始就没打算让机器读
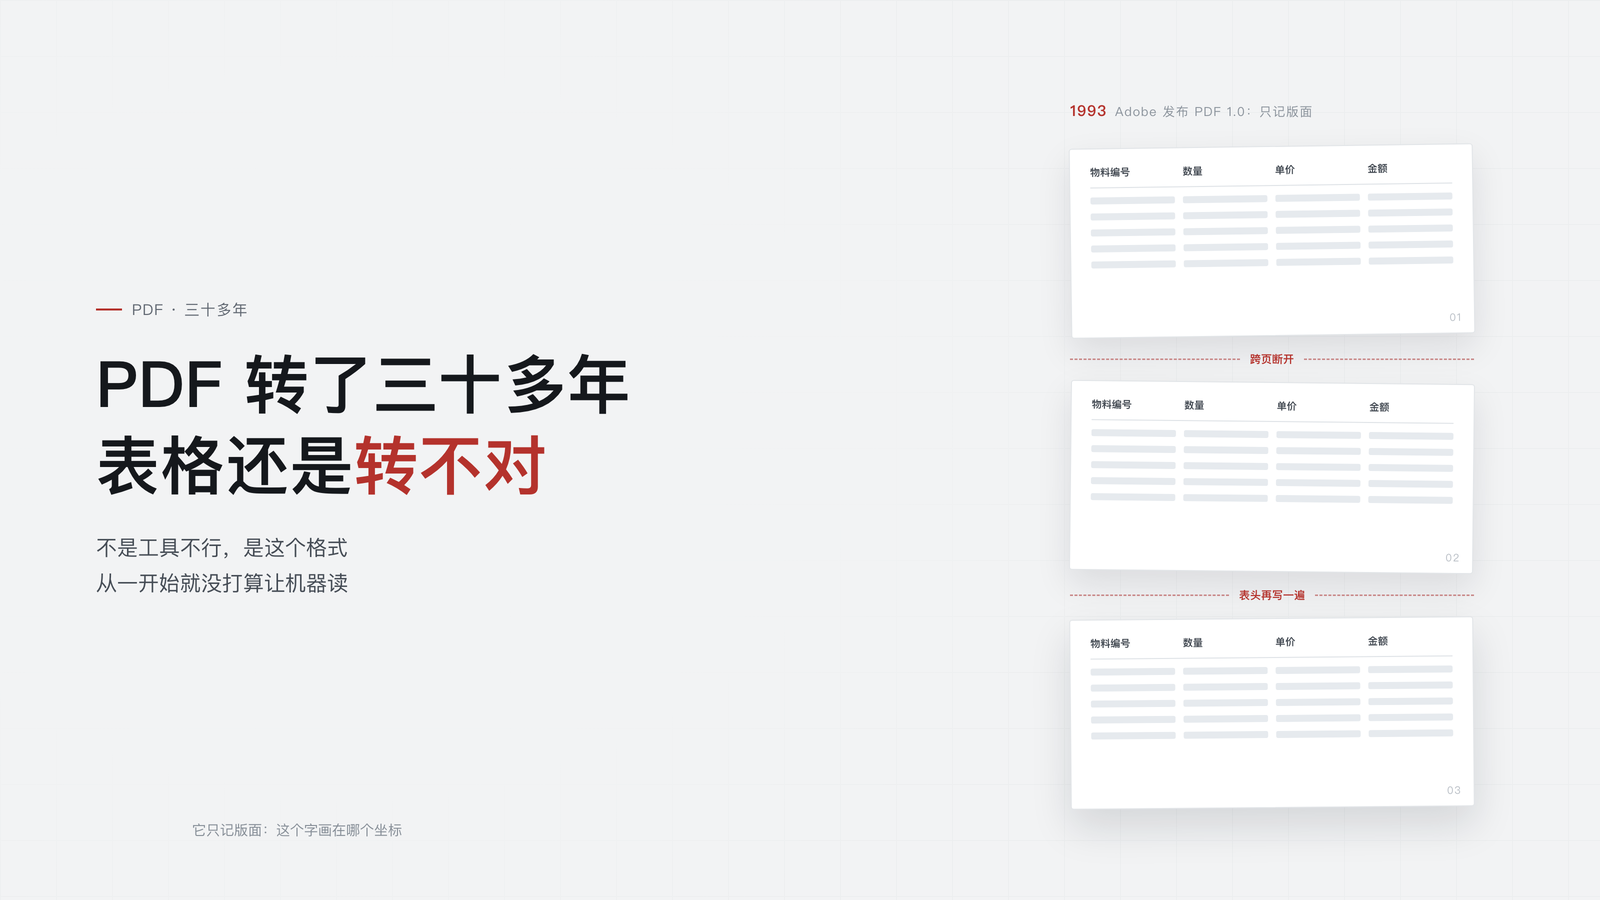
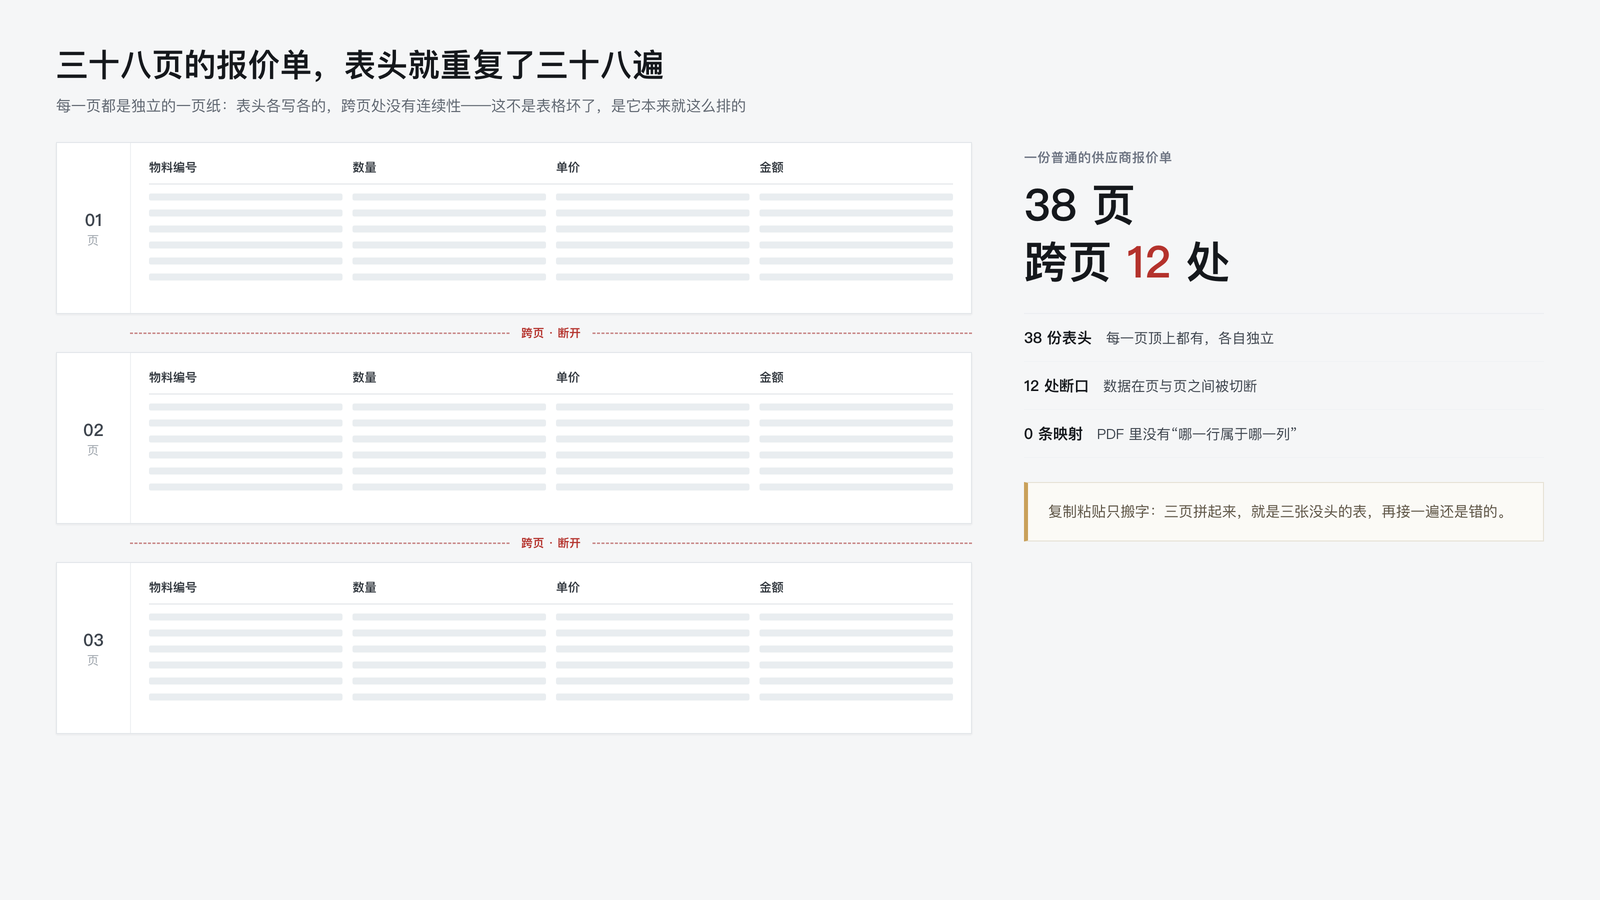
每个月月初,业务要把供应商发来的报价单转成 Excel。三四十页,跨页十几处,表头在每页顶上重复一遍。用复制粘贴,转完一列一列对,两个小时。
这是件小事,但它其实是一个三十多年前的设计决定,到今天还在收利息。
1993 年 6 月,Adobe 发布 Acrobat 1.0,同时公开了 PDF 1.0 的规范。目标很明确:在任何机器上打印出来都一样。这个目标确实达到了,代价是它只记版面——这个字画在哪个坐标,不记这个数属于哪一行哪一列。
对打印来说,这没问题。对要拿数据干活的机器来说,这是道墙。
这道墙堵住的是一整类活
表格只是最日常的一例。合同要多版本比对,发票要录入,年报要提取,研究报告要汇总——只要源头是 PDF,第一道工序都一样:先把它变成能算的东西。
这些年大家想了不少办法。有人上 OCR,有人做模板,有人干脆雇人敲。办法都管用,共同点是同一个:先默认这份文件不可读,再想办法去补。
换个思路,先看图,再读字
人看一页表,一眼就分得清哪儿是表头、哪儿是合并单元格。机器不是做不到,是过去一直在读字,没在看版面。
现在的做法可以换个顺序:先判断这份 PDF 里是文字还是图,再按版面把结构还原出来——表头单独提出来,跨页的接成一张,金额和日期存成能直接算的格式。
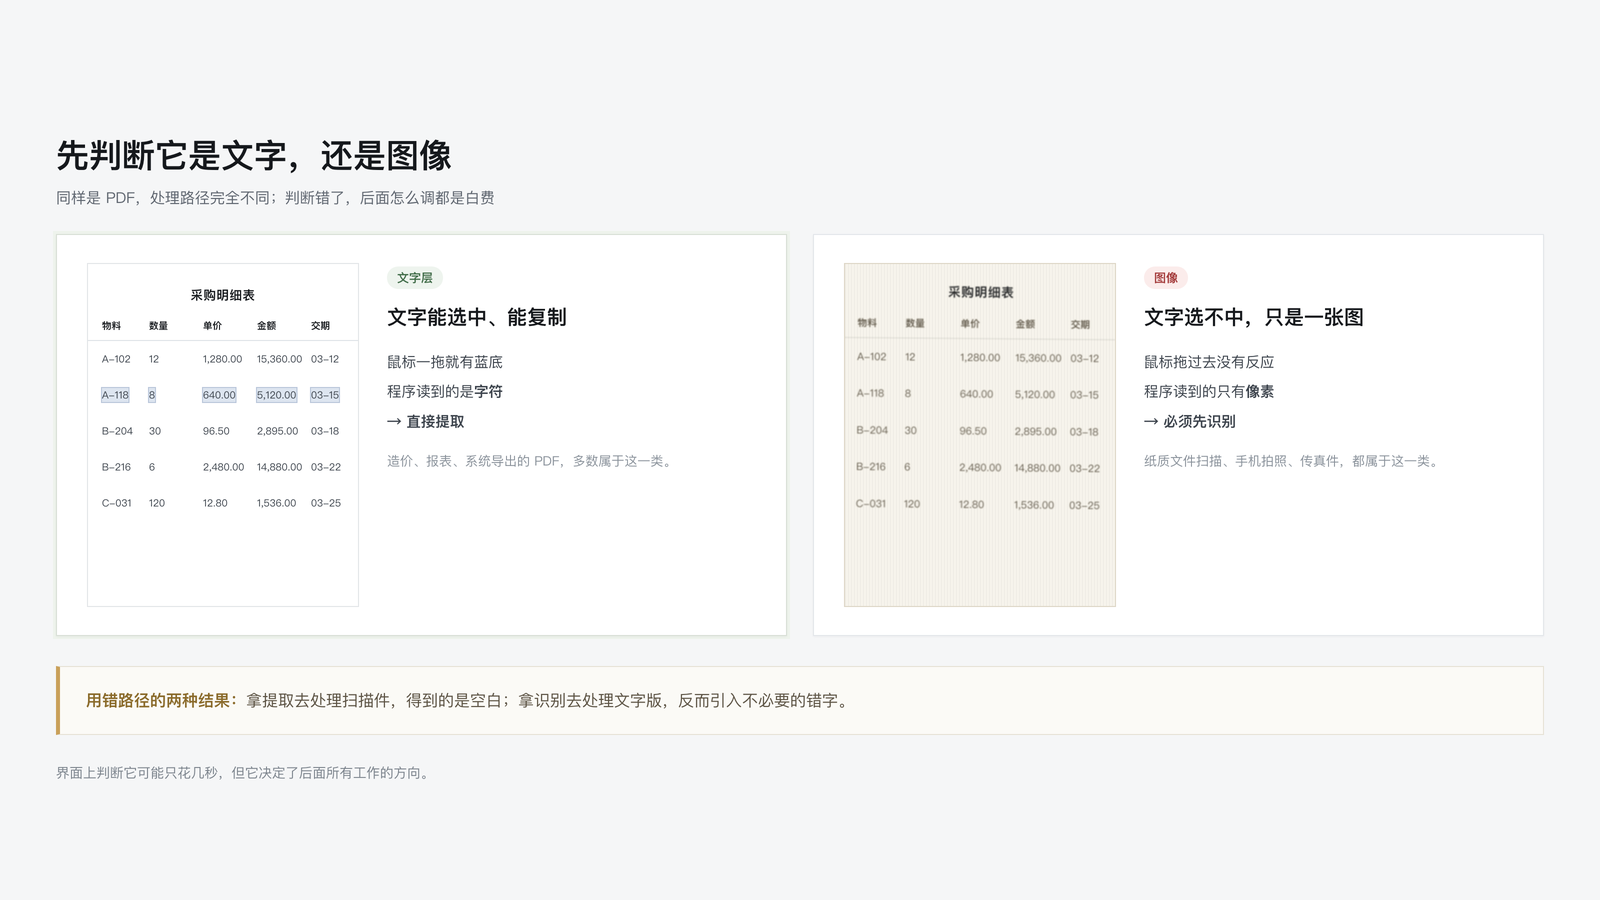
Mirawork 走的就是这条路。它第一步不是提取,是判断类型:文字版直接抽,扫描件先识别。这一步看错,后面全白做。
转出来,往往只是开始
一张表转出来通常不是为了看,是为了往下算:按部门汇总、做对比图、写成一份给采购的说明。
过去这段要换工具、重新导一遍、再解释一次这表是干什么的。现在可以在同一个任务里接着提要求,文件不用重传。
格式债不会自己消失
PDF 不会变少,只会变多。合同、发票、报告、公告,绝大多数最后都以 PDF 定稿,因为它是最稳妥的交付格式——谁打开都一样。
2008 年,PDF 交给 ISO 管,编号 32000-1;2017 年又出了 2.0 版。标准换了主人,前后七个版本,但「记位置不记结构」的底子一直没动。今天转一张表踩的坑,还是三十年前那几个。
这意味着「把 PDF 变成能用的数据」这道工序会长期存在。它现在被当成杂活,实际上每年吞掉的是大量本可以拿去做判断的时间。
三十多年前那个「打印出来一模一样」的目标,完成得漂亮。现在要补的,是它的另一面。
一份三四十页的报价单,说到底不该花两个小时。
最后·关于 Mirawork
Mirawork 是上海锐文智源科技有限公司开发的桌面 AI 办公智能体,说清目标、给出材料,它拆解任务并交付可继续编辑的 Word、Excel、PPT、PDF 文件。支持 Word、Excel、PPT、PDF、图片和代码等常见格式。面向需要处理正式文书与结构化材料的办公场景。(具体格式与处理能力以客户端当前版本为准。)
免责声明:本文为企业宣传商业资讯,仅供用户参考,如用户将之作为消费行为参考,凤凰网敬告用户需审慎决定。



